ALNETS · Artículos técnicos
RAG empresarial local: desde computación perimetral de 16 GB hasta enrutamiento de puerta de enlace API unificada
Una guía práctica para RAG empresarial sin pérdida de datos, que detalla la búsqueda de vectores locales, la inferencia de borde de VRAM de 16 GB y el enrutamiento de borde de nube híbrido a través de una puerta de enlace API empresarial.
Conclusiones rápidas (TL;DR)
La creación de una base de conocimientos empresariales (RAG) local no exige clústeres de GPU de centros de datos de alta potencia, ni tampoco se deben cargar códigos fuente propietarios, auditorías financieras o contratos en nubes públicas en texto sin formato. La arquitectura probada es un sistema híbrido por niveles: fragmentación de documentos con pines, incrustaciones de vectores densos e inferencia de modelos de borde 7B-14B en hardware VRAM de 16 GB (como AE-2000) para que los datos confidenciales nunca salgan de la LAN, al mismo tiempo que enruta el razonamiento no confidencial a través de una puerta de enlace API centralizada a los LLM autorizados en la nube fronteriza.
Tres cuellos de botella críticos en Enterprise RAG
Al trasladar las bases de conocimiento del PoC interno a la producción entre departamentos, los arquitectos de TI se topan con tres obstáculos principales:
- Soberanía y cumplimiento de datos: los acuerdos legales, los NDA de clientes y las patentes de propiedad no pueden salir de los firewalls empresariales, bloqueando los modelos SaaS públicos puros.
- Costos de tokens y latencia de red: la incorporación y búsqueda vectorial repetida de decenas de miles de manuales corporativos genera un aumento en las facturas de API en la nube e introduce picos de latencia de red.
- Fragmentación de control de acceso y concurrencia: los silos departamentales (por ejemplo, RR.HH. frente a I+D) requieren un control de acceso granular que los scripts ad-hoc no pueden aplicar de manera confiable bajo carga concurrente.
Calcular la matriz de selección de modelos y dimensionamiento
| Perfil de cálculo | VRAM y simultaneidad | Modelos de destino y cargas de trabajo | Hardware recomendado |
|---|---|---|---|
| Computación perimetral ligera | 16 GB de VRAM, admite entre 5 y 30 usuarios de equipos simultáneos | Incorporaciones de BGE-M3, inferencia local y reclasificación de Qwen-2.5-7B/14B Q4 | Computadora de IA de vanguardia industrial AE-2000 |
| Estación de trabajo de alto rendimiento | 32 GB-64 GB+ VRAM, admite entre 50 y 200 usuarios de equipos simultáneos | Modelos 32B-70B para razonamiento profundo y ajuste local local | Serie de estaciones de trabajo AiW-V / AW AI |
| Enrutamiento y gobernanza | Gestiona el enrutamiento del tráfico, la autenticación y el almacenamiento en caché (sin sobrecarga de GPU) | Equilibrio de carga multimodelo, medición de tokens, puerta de enlace de autenticación de intranet | Puerta de enlace API de IA empresarial |
Topología de borde de nube híbrida sin fugas
Para lograr el equilibrio ideal entre la confidencialidad de los datos aislados y la inteligencia de resultados, implemente una topología híbrida de borde de nube:
- Canalización LAN confidencial: los manuales, esquemas y archivos PDF sin procesar de la empresa permanecen estrictamente en las instalaciones. La ingesta de documentos, la fragmentación de vectores y la indexación de bases de datos se ejecutan localmente en el host perimetral AE-2000 sin transmitir texto sin formato al exterior.
- Envío de puerta de enlace inteligente: la recuperación de rutina y las consultas confidenciales se realizan en su totalidad mediante modelos locales 7B/14B. Las solicitudes de razonamiento complejas se enrutan a través de la puerta de enlace API empresarial con anonimización automatizada.
- Copia de seguridad en frío automatizada: combínelo con un NAS empresarial local para obtener instantáneas diarias programadas de incrustaciones de vectores e índices de conocimiento, evitando pérdidas catastróficas de datos.
Hoja de ruta de implementación de RAG empresarial de cinco pasos
- Paso 1: Limpieza de documentos y asignación de roles. Audite los repositorios departamentales, archive activos obsoletos y defina niveles de clasificación de acceso.
- Paso 2: Puesta en marcha del hardware perimetral. Monte el AE-2000 en bastidor o en escritorio en el conmutador departamental, inicializando contenedores de base de datos vectoriales.
- Paso 3: estrategia de fragmentación y calibración de integración. Aplique fragmentación semántica para tablas y especificaciones técnicas, ajustando vectores BGE-M3.
- Paso 4: Implementación de pasarela de API. Enrute a los clientes de chat de los usuarios a través de la puerta de enlace, estableciendo cuotas de tokens, límites de latencia y rutas alternativas.
- Paso 5: Integración del cliente y ajuste de recuperación iterativa. Conéctese a clientes de portal o mensajería empresarial interna y monitoree la precisión de la recuperación de Top-K.
Preguntas frecuentes (FAQ)
Consideraciones de ingeniería frecuentes:
- P: ¿Puede una unidad VRAM de 16 GB admitir de manera realista a docenas de usuarios empresariales? R: Sí. El cuello de botella computacional es la recuperación de vectores (manejada eficientemente en RAM/CPU) y la reclasificación (en menos de un segundo). Por generación, los modelos optimizados de 4 bits 7B-14B consumen solo 6 GB-10 GB de VRAM a 30-50 tokens/seg. Junto con la gestión de colas de puerta de enlace API, presta servicio fácilmente a equipos de entre 10 y 50 usuarios.
- P: ¿La base de conocimientos local sigue funcionando durante los cortes de Internet? R: Absolutamente. Debido a que el análisis de documentos, la indexación de vectores y los modelos de inferencia local residen dentro de su LAN en el AE-2000, los equipos internos conservan el 100 % de las capacidades de búsqueda y control de calidad incluso durante apagones completos de la WAN.
SINERGIA DE ARQUITECTURA Y HARDWARE
Productos y Paquetes Recomendados
Dispositivos de hardware, pasarelas y suites colaborativas a las que se hace referencia en esta guía:
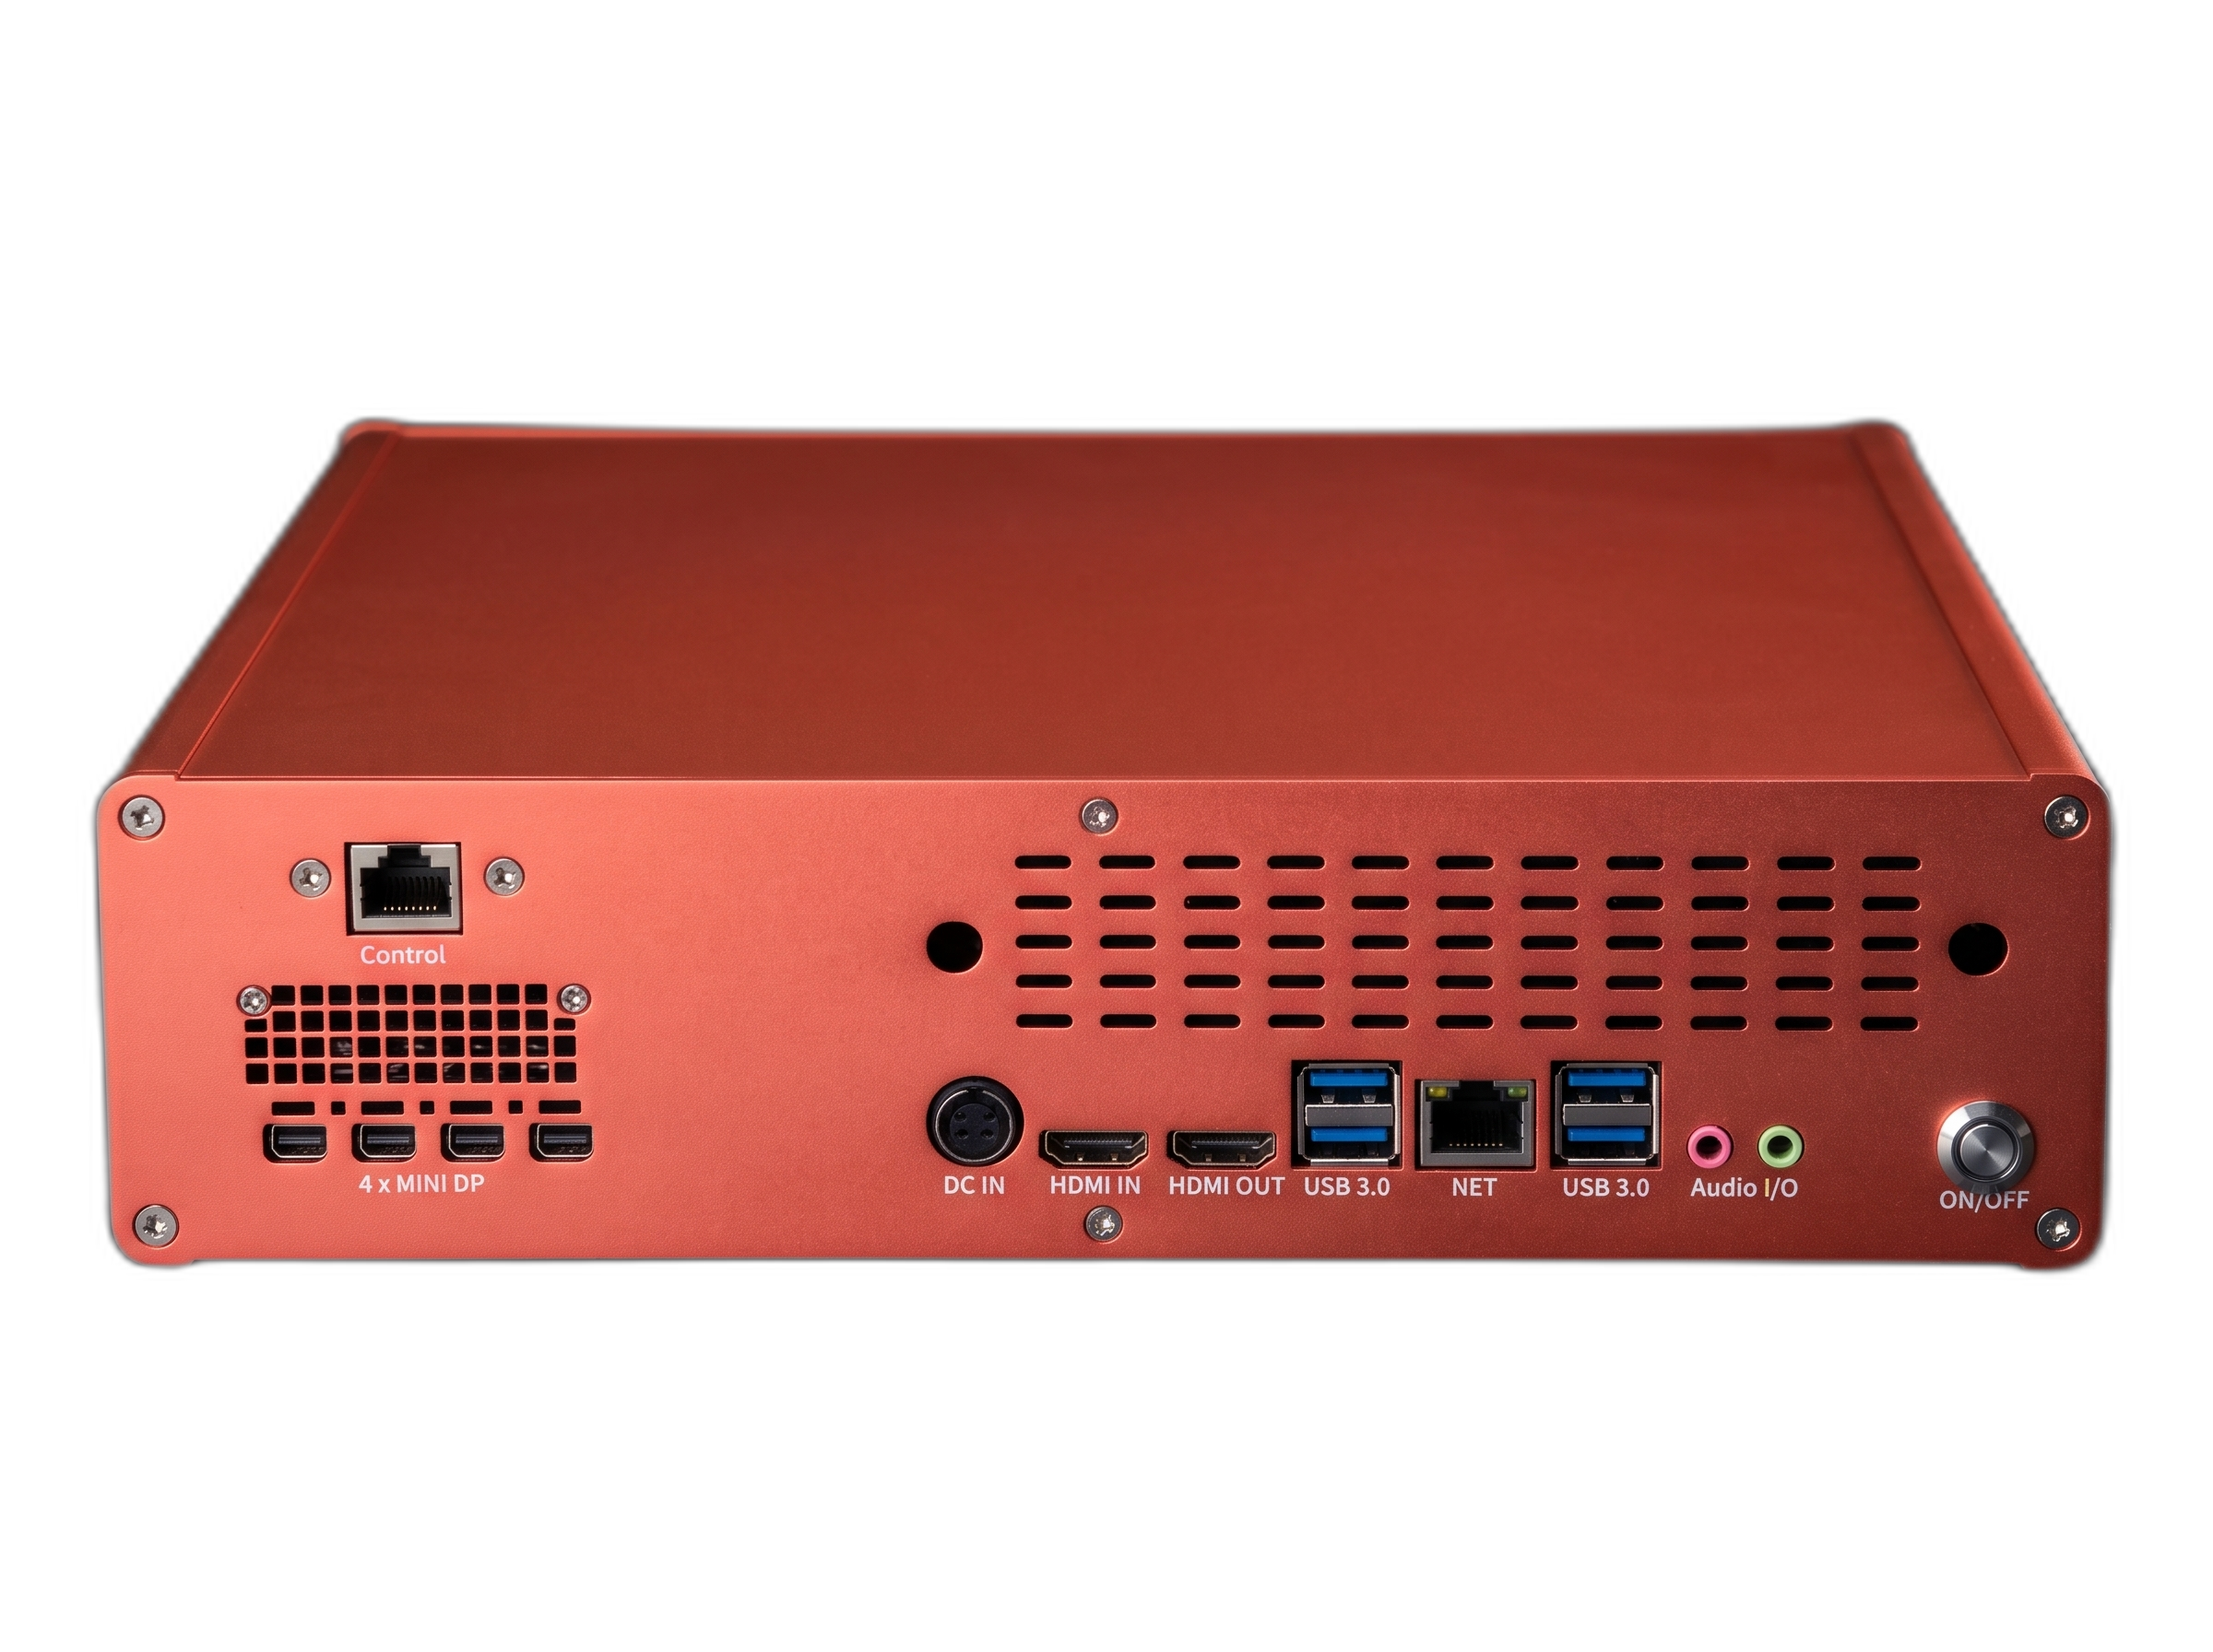
AE-2000 Computadora Industrial de IA en el Borde
Cómputo local de IA para entornos industriales y comerciales con dos configuraciones. Ambos modelos equipan GPU NVIDIA RTX 2000 Ada con 16GB GDDR6 ECC.
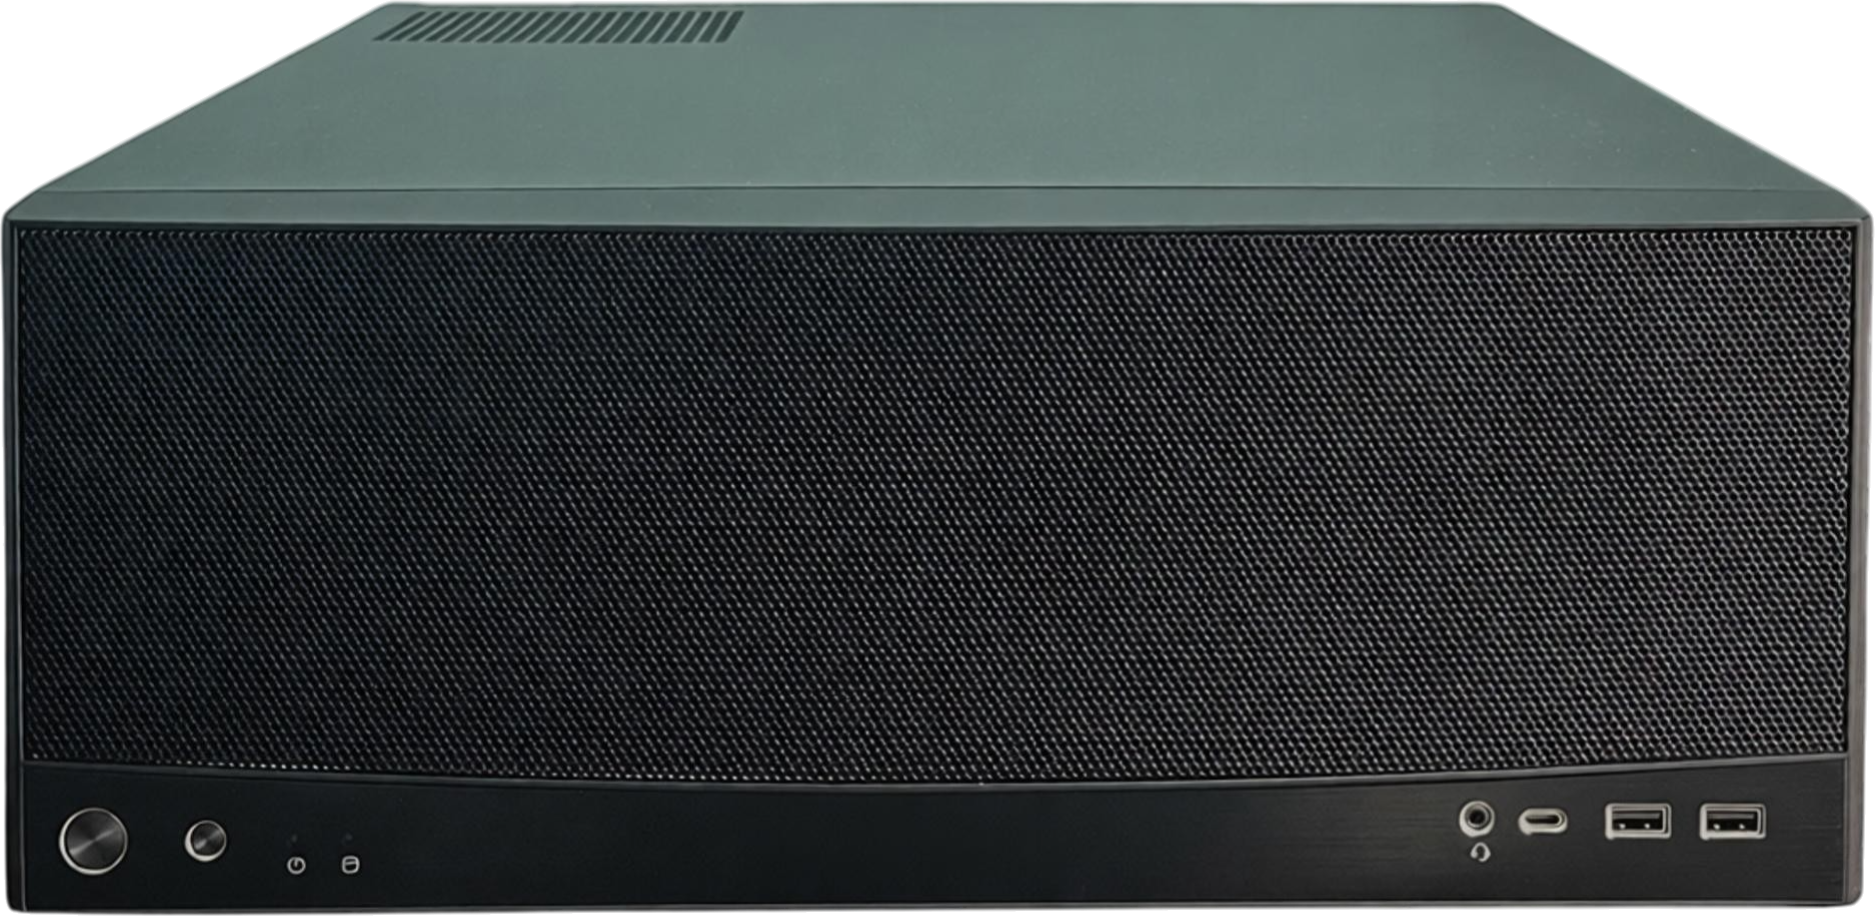
AiW-V Estación de Trabajo Local de IA
Estación de trabajo accesible con 32GB/64GB de VRAM que traslada LLMs principales y creación de video offline a su escritorio.
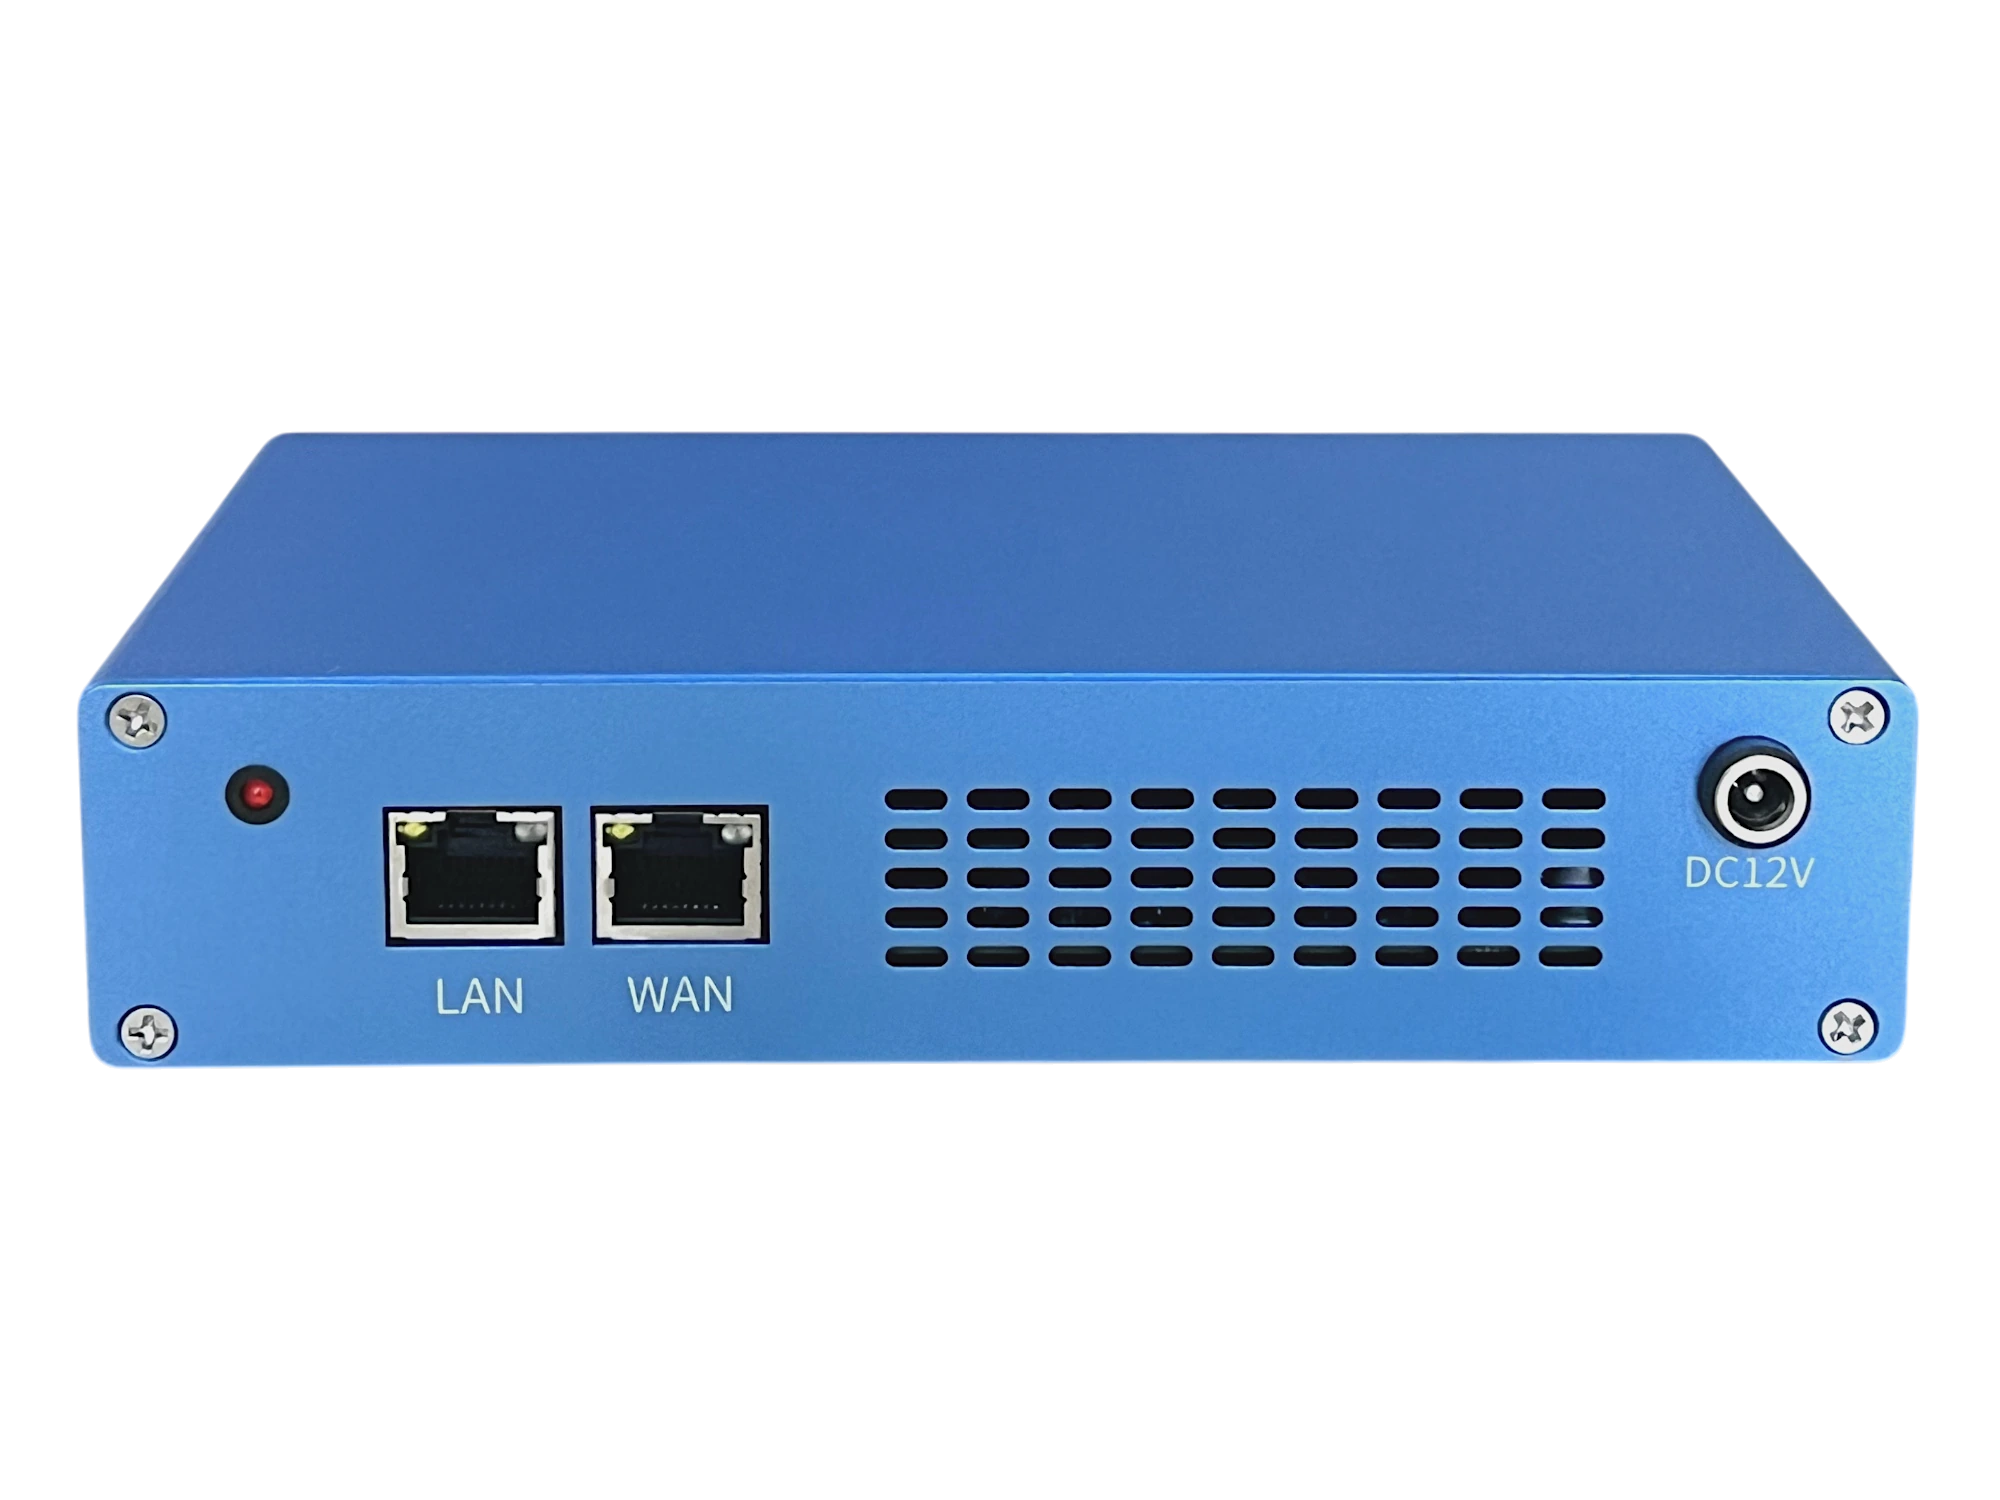
Pasarela de API de IA Empresarial
Enrutamiento centralizado de modelos, medición de tokens y control de concurrencia. Próximamente.
Puerta de enlace de IA empresarial y suite colaborativa
Topología de hardware integrada, límite de seguridad y suite llave en mano
Base de Conocimiento Privada y Centro de Preguntas y Respuestas para Empresas
Transforma manuales de producto, guías de instalación, árboles de resolución de problemas y normativas internas en un motor privado de conocimiento de alta precisión con confidencialidad absoluta.
Pasarela Unificada de API de IA Empresarial y Sinergia Multidispositivo
Establezca una infraestructura de IA gobernada y segura: elimine configuraciones dispersas, cuentas no coordinadas, fugas de credenciales y costos opacos de API.