ALNETS · Guías de implementación
Inferencia de modelo y host del agente: separe el tiempo de ejecución del proceso
Un host de agente ejecuta el cliente, las herramientas y el espacio de trabajo de tareas. La inferencia proviene de una puerta de enlace API centralizada o de un servicio de modelo local. Desacoplar el tiempo de ejecución garantiza un control de costes limpio.
respuesta corta
Trate el host del agente como un tiempo de ejecución de tarea dedicado, no como hardware de inferencia o entrenamiento de modelos. Decida dónde se ejecutará el modelo y luego planifique el host del cliente, el servicio del modelo y la red por separado.
Qué hace el host del agente
El host ejecuta el cliente del Agente, las herramientas y el directorio de tareas en un entorno de usuario dedicado. Para uso empresarial, planifique un host por usuario. Configure cuentas, permisos de herramientas y acceso a datos según los requisitos de la organización.
- Confirmar clientes, herramientas y dependencias.
- Defina directorios de trabajo y límites de datos empresariales.
- Defina el manejo de interrupciones, ahorro de producción y intervención humana.
Elija una ruta de inferencia
| Camino | Consideraciones | Beneficios de la arquitectura |
|---|---|---|
| Inferencia en la nube de Unified pasarela de API | Se autoriza un servicio de modelo externo a través de gateway. | Auditoría de tokens centralizada; Las teclas nunca tocan las PC Edge. |
| Servicio de modelo de borde local | Los datos empresariales confidenciales deben permanecer en la LAN. | Latencia inferior a un segundo con coste cero de ancho de banda WAN. |
Mantenga la conectividad dentro del alcance
AiR es opcional, dependiendo de las necesidades de conectividad externa. La LAN local transmite llamadas directamente a servicios modelo locales; Al llamar a modelos externos, AiR y la puerta de enlace API empresarial proporcionan un túnel seguro.
SINERGIA DE ARQUITECTURA Y HARDWARE
Productos y Paquetes Recomendados
Dispositivos de hardware, pasarelas y suites colaborativas a las que se hace referencia en esta guía:
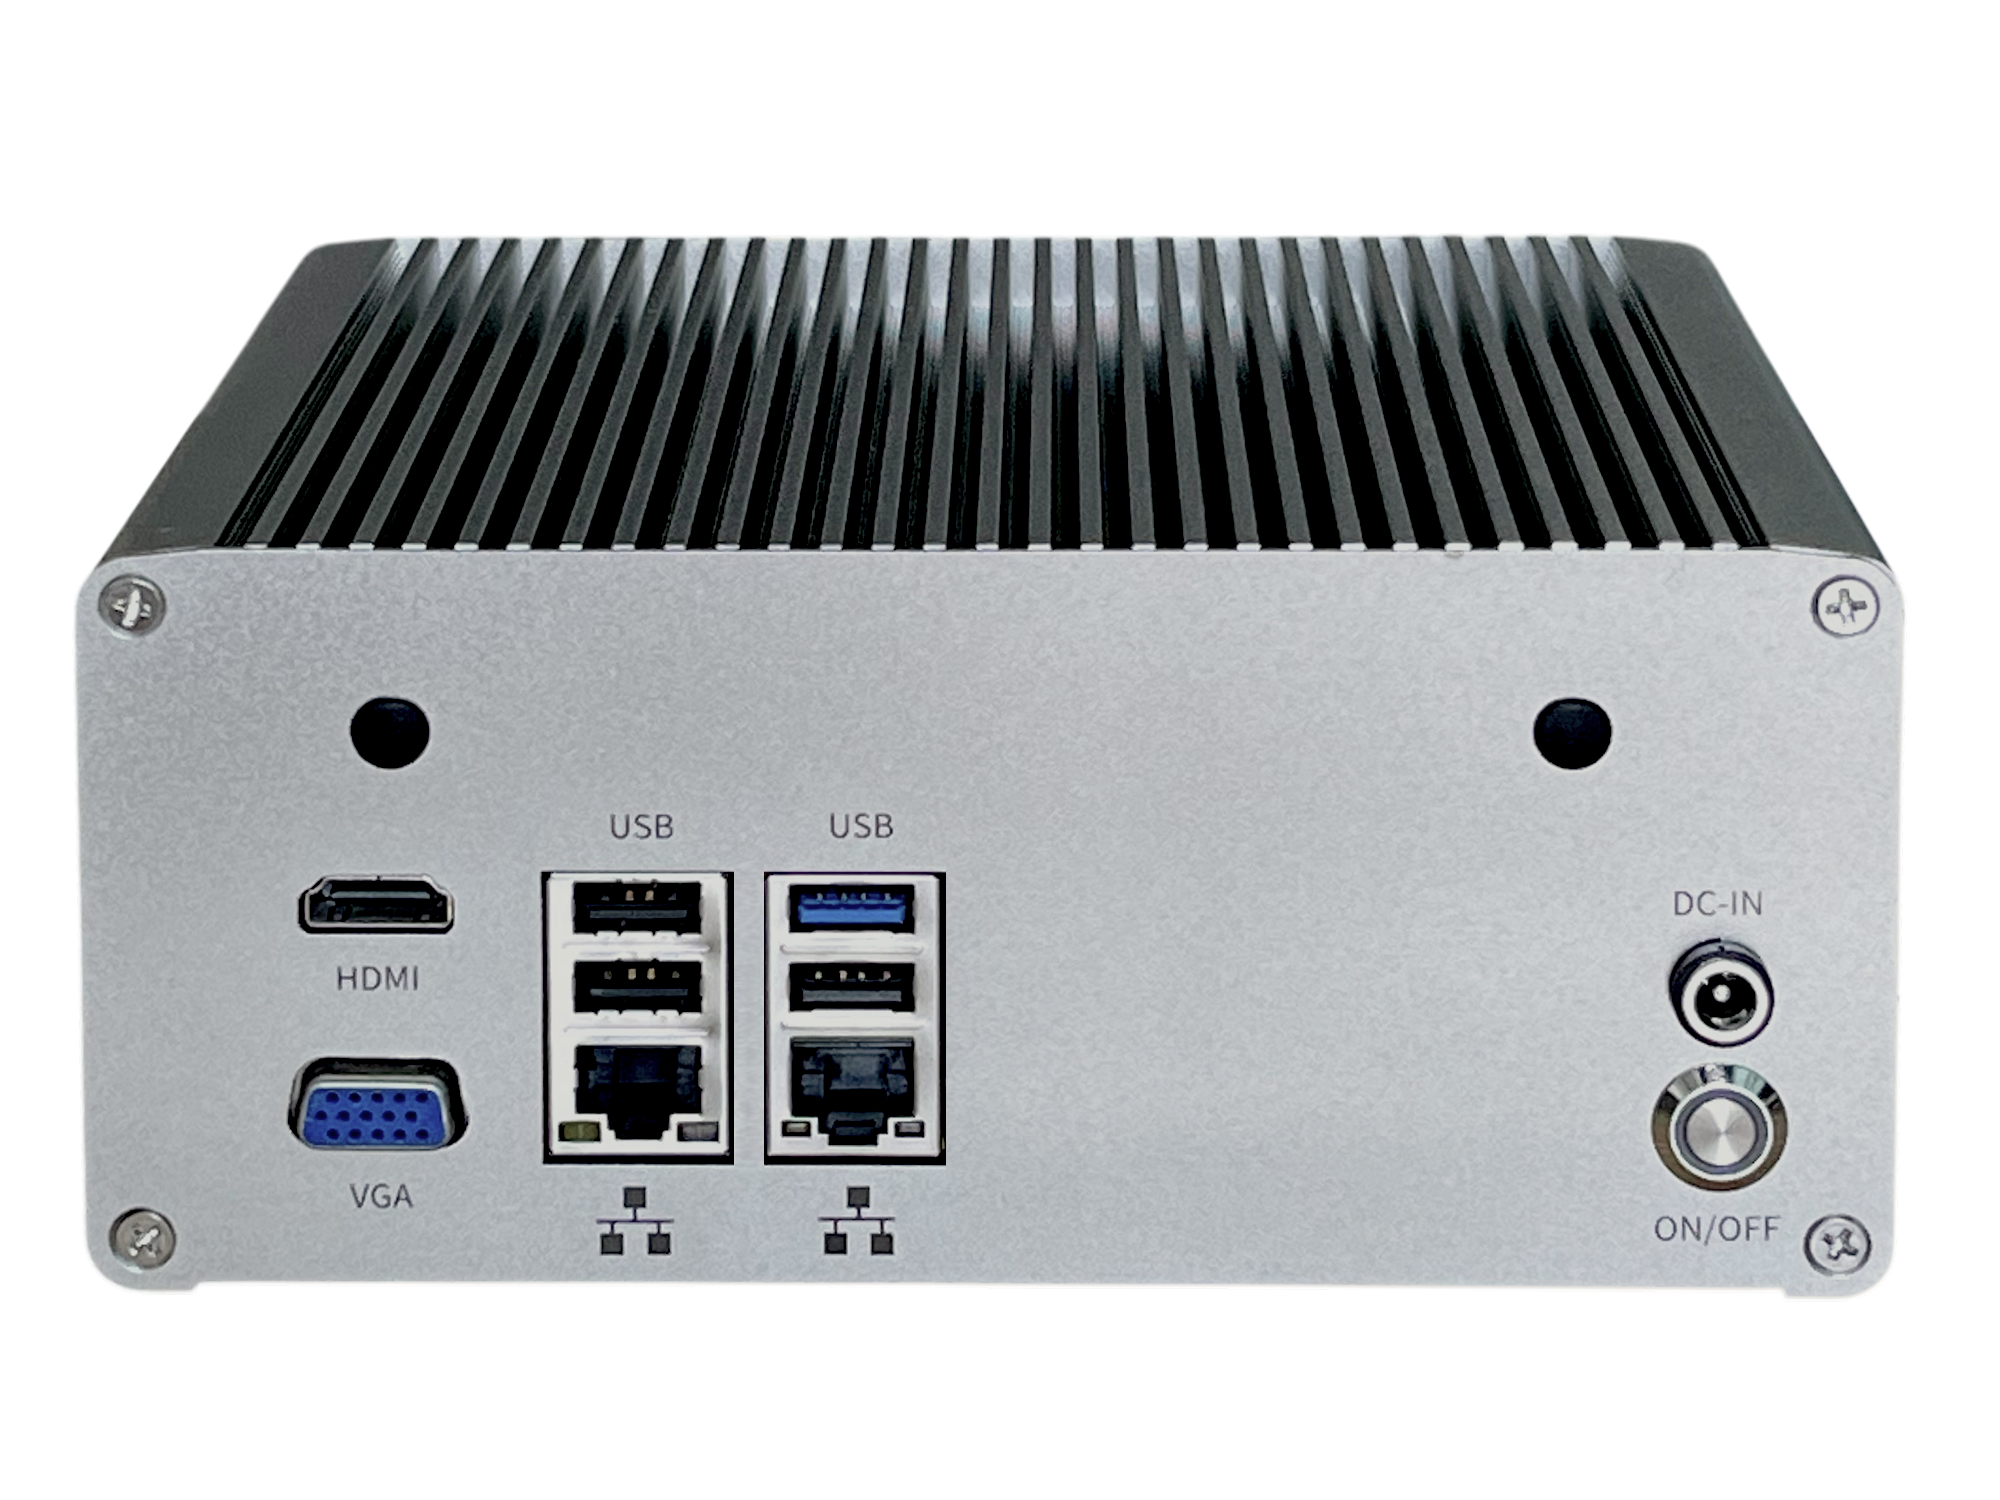
AiA Servidor de Agentes de IA
Servidor silencioso en el borde para ejecución 24/7 de agentes de IA con solo 10W de consumo.
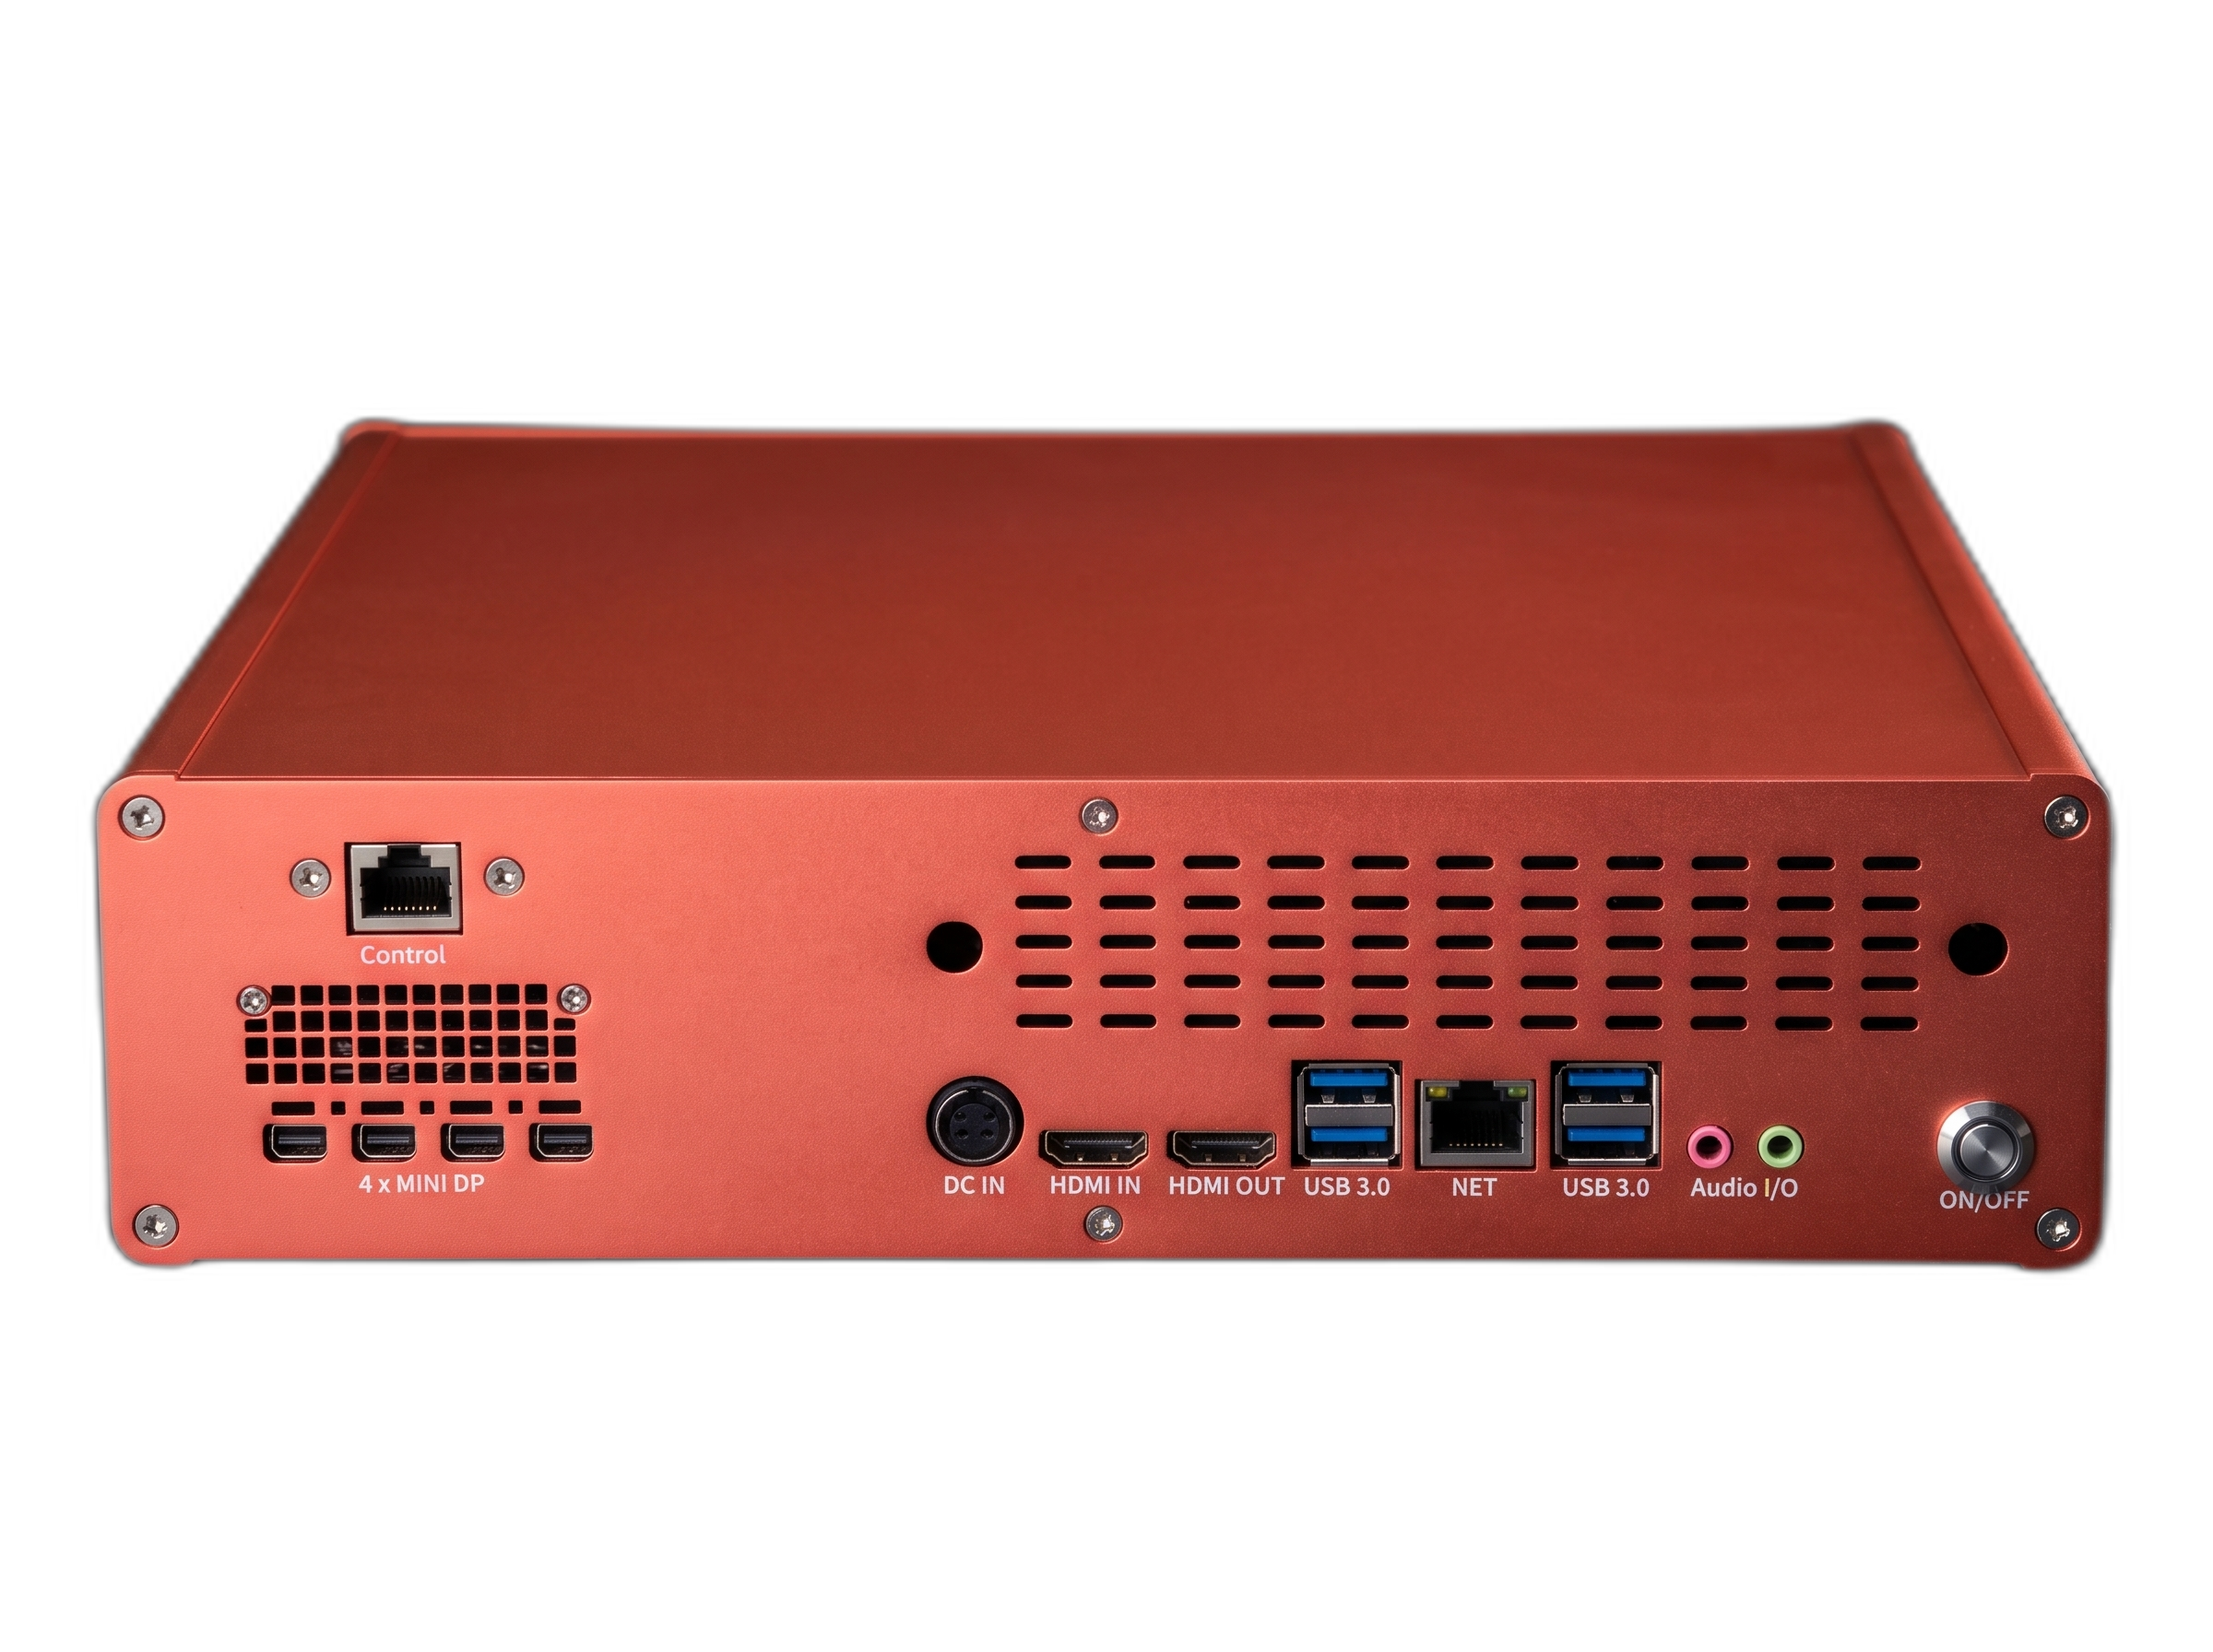
AE-2000 Computadora Industrial de IA en el Borde
Cómputo local de IA para entornos industriales y comerciales con dos configuraciones. Ambos modelos equipan GPU NVIDIA RTX 2000 Ada con 16GB GDDR6 ECC.
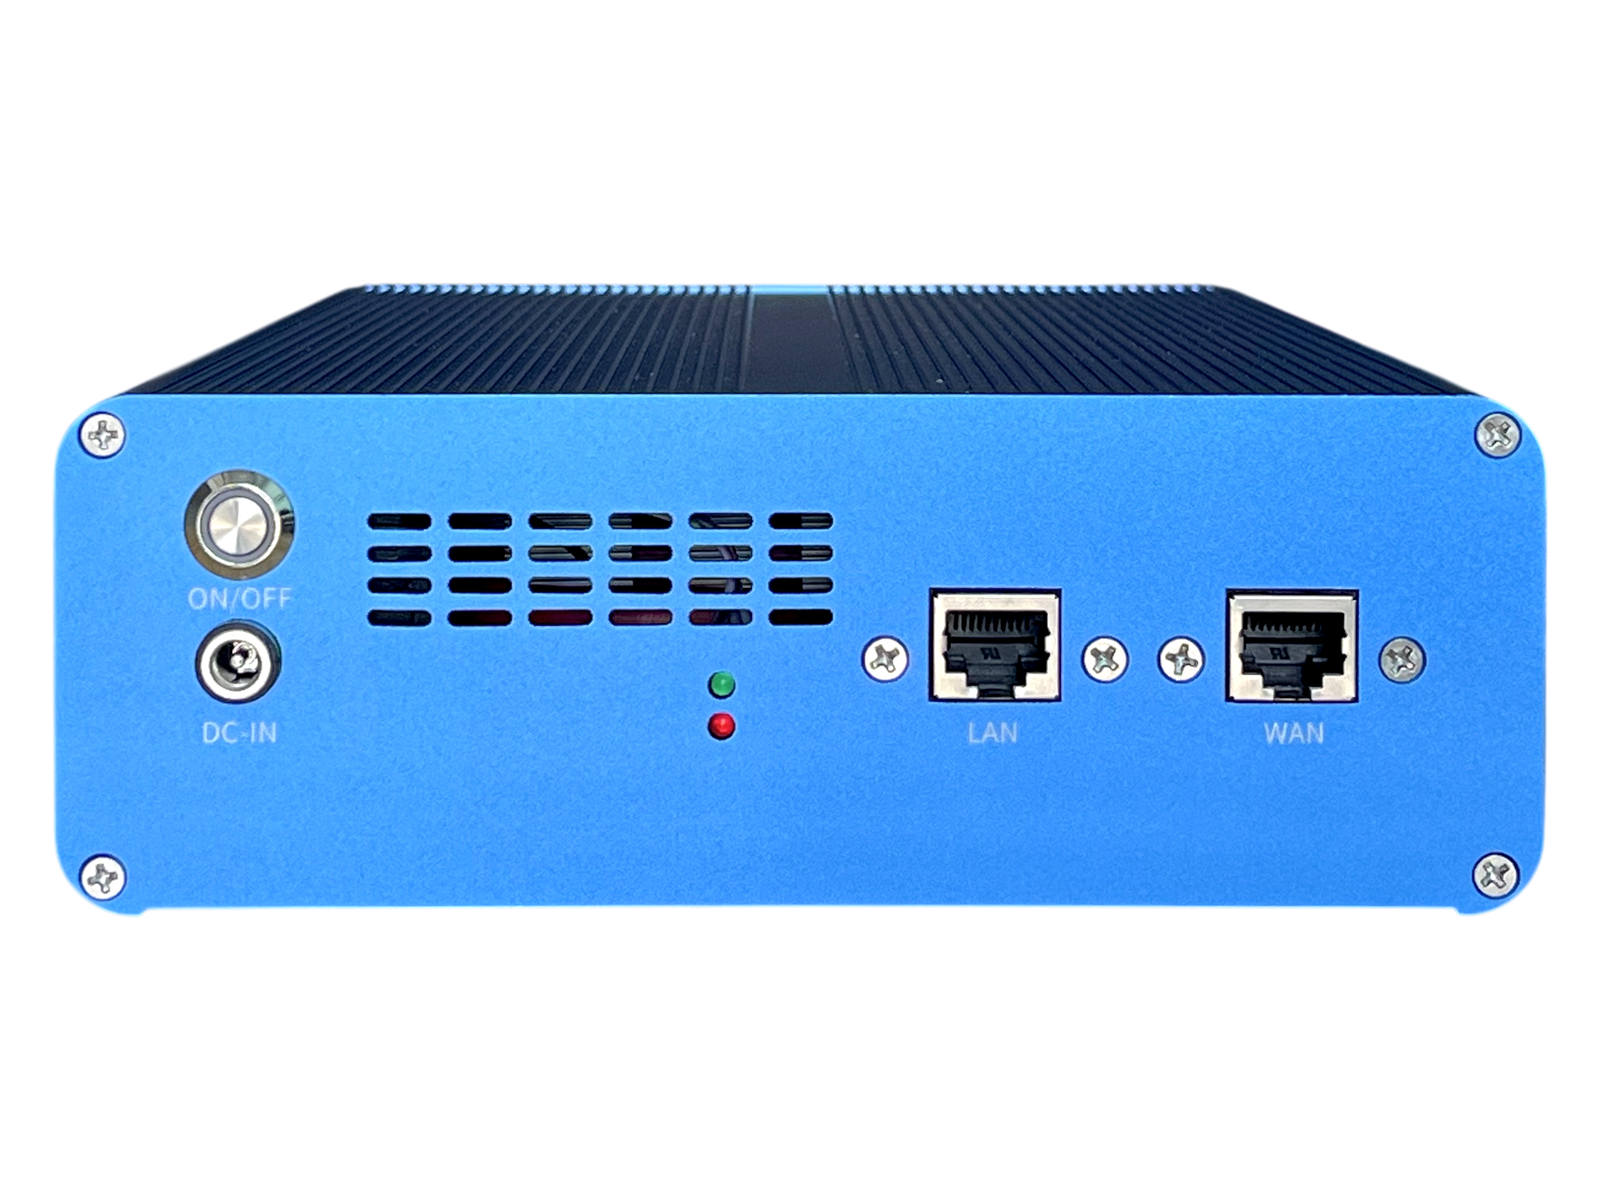
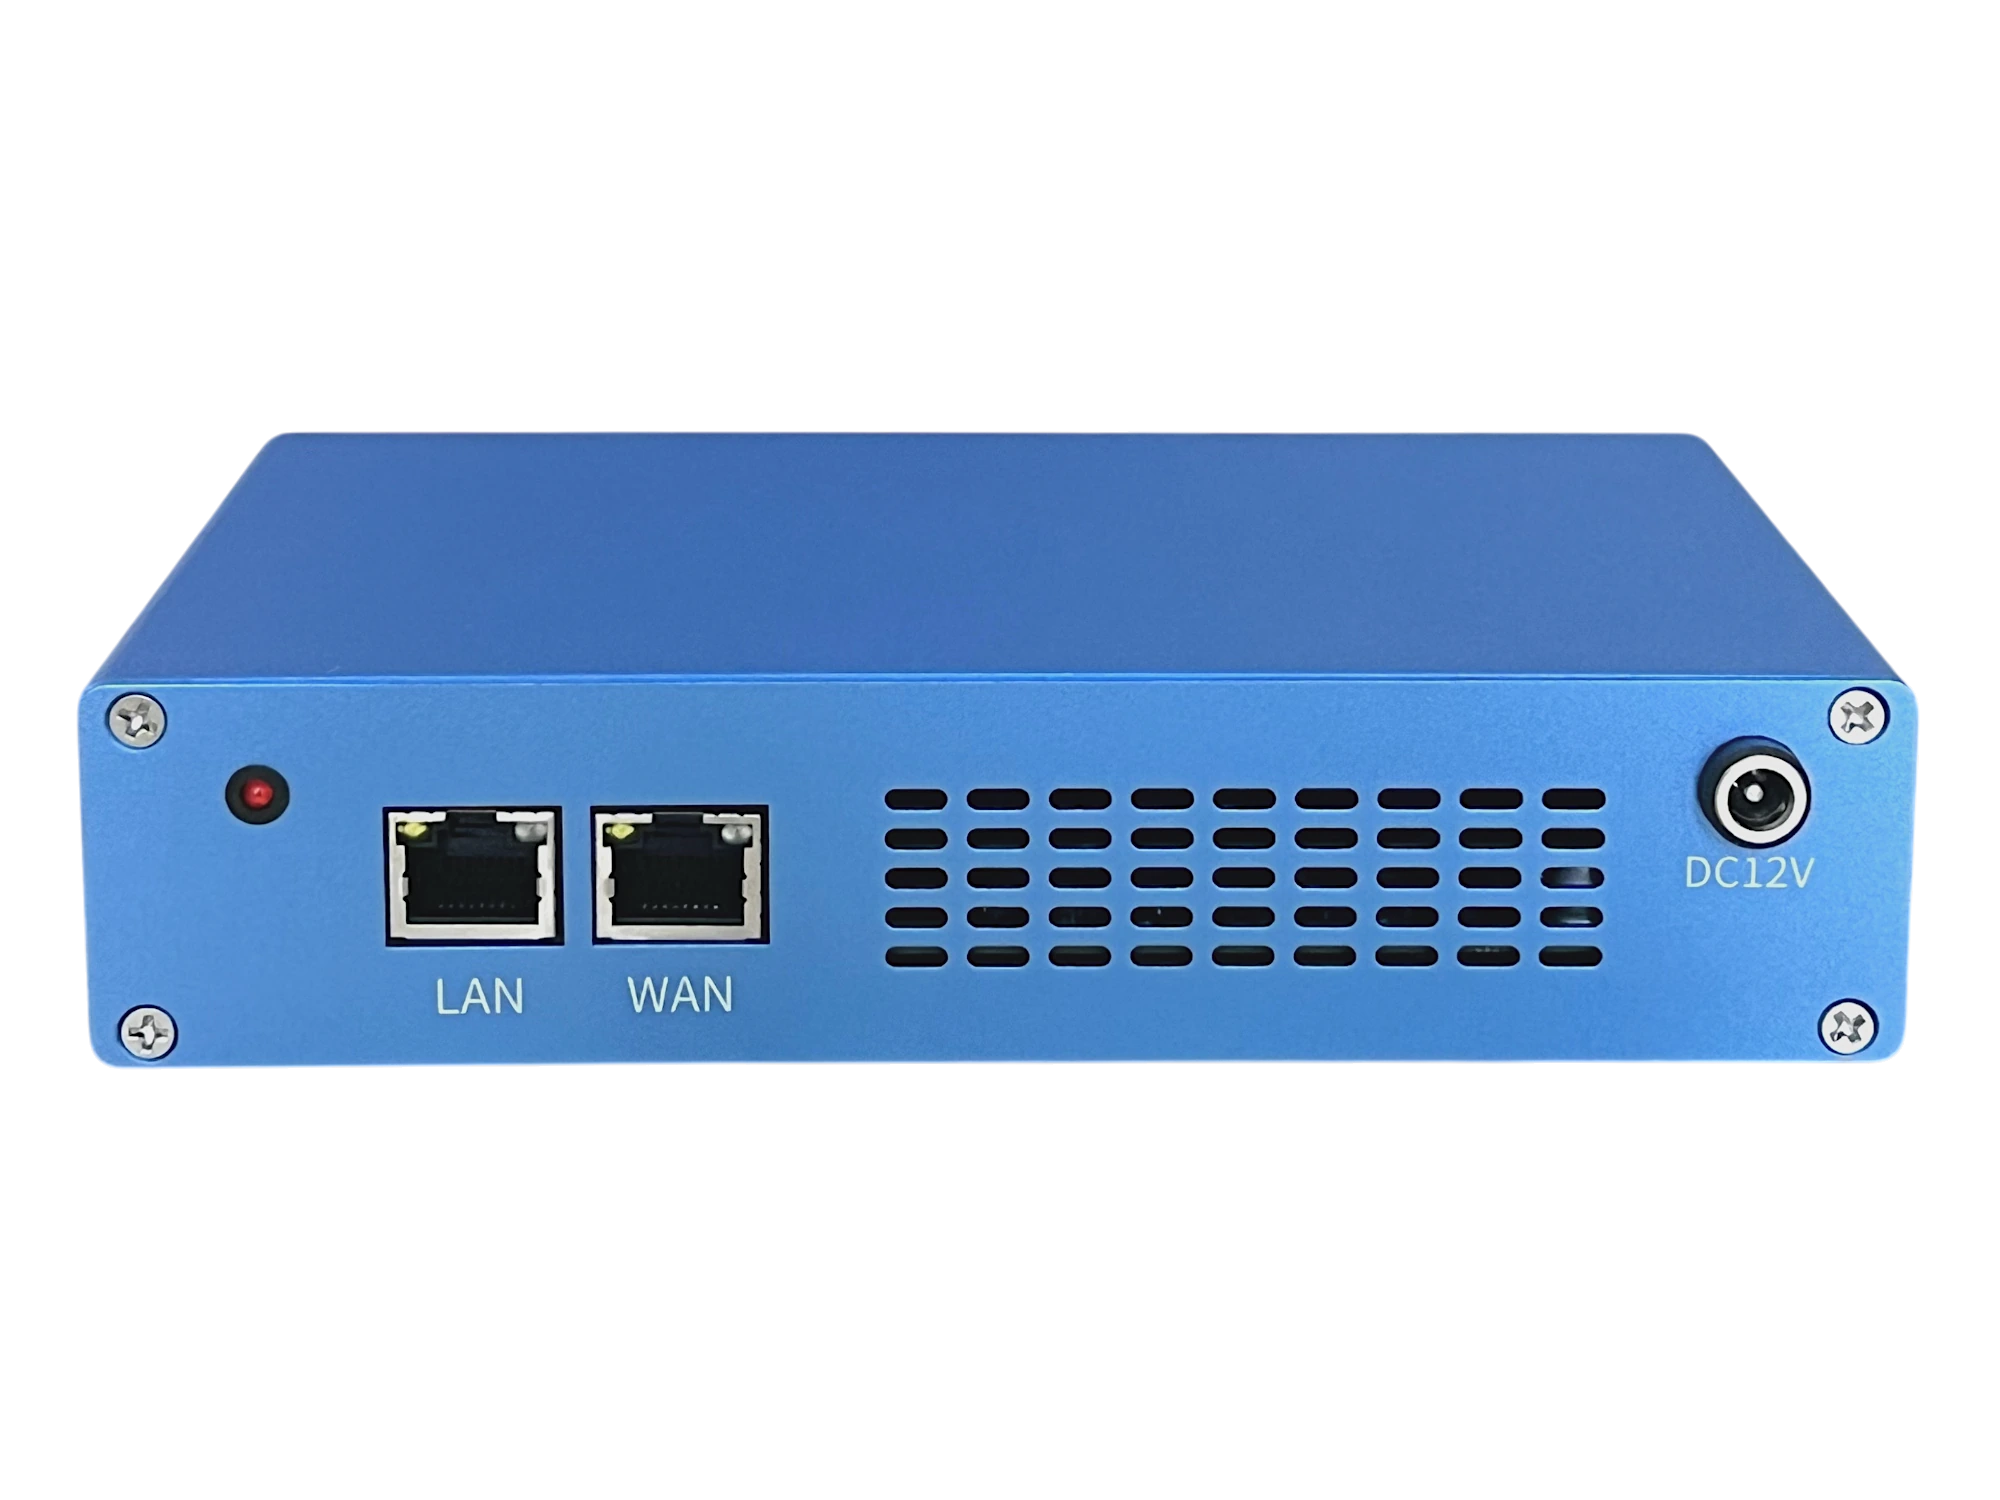
AiR Enrutador Pasarela en la Nube de IA
Túnel cifrado seguro, enrutamiento multi-WAN y pasarela de acceso remoto para IA en el sitio.
Pasarela de API de IA Empresarial
Enrutamiento centralizado de modelos, medición de tokens y control de concurrencia. Próximamente.
Solución de espacio de trabajo para agentes
Topología de hardware integrada, límite de seguridad y suite llave en mano
Anfitrión del espacio de trabajo del agente AiA
Topología de hardware integrada, límite de seguridad y suite llave en mano
Enrutador de puerta de enlace en la nube AiR AI
Topología de hardware integrada, límite de seguridad y suite llave en mano
Espacio de Trabajo para Agentes Autónomos Dedicados 24/7
Despliegue servidores dedicados AiA, red segura AiR, gobernanza de modelos por empleado con la pasarela de API y recuperación de conocimiento privado con AE-2000, adaptando modelos, documentos y herramientas por rol.